OpenAI i Anthropic: Jak zajišťují autonomii a bezpečnost finančních agentů
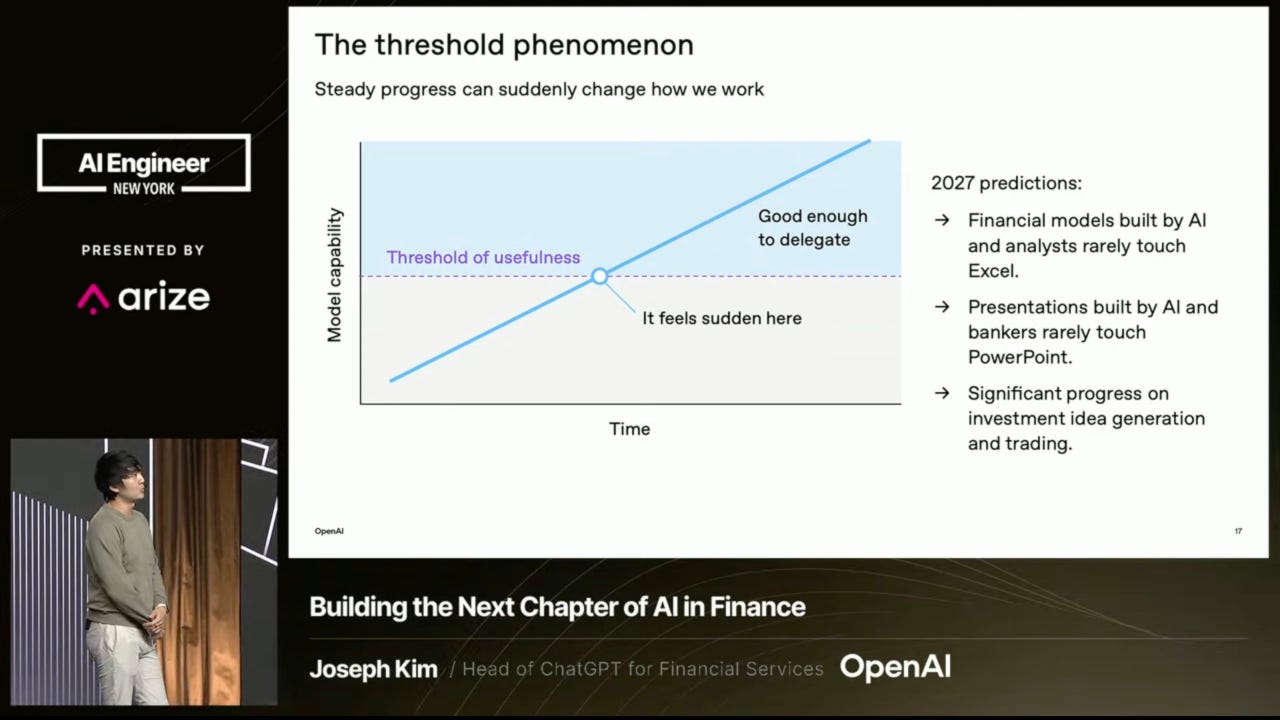
Na konferenci AI Engineer New York Joseph Kim z OpenAI představil pojem „threshold of usefulness“, který označuje bod, kdy modely šetří čas analytiků. Předpovídá, že do roku 2027 budou agenti schopni generovat investiční nápady a provádět obchodování, přičemž bezpečná autonomie závisí na umístění kontrol a lidského úsudku.
Na konferenci AI Engineer New York Joseph Kim z OpenAI představil pojem „threshold of usefulness“. Podle něj modely dosáhnou bodu, kdy jsou dostatečně spolehlivé, aby šetřily čas analytiků při každodenní práci. Kim předpověděl, že do roku 2027 budou agenti schopni generovat investiční nápady a provádět obchodování.
Obě společnosti, OpenAI i Anthropic, zdůrazňují, že bezpečná autonomie vyžaduje umístění kontrol a lidského úsudku. Nejde o počet omezení, ale o to, kde jsou zásahy integrovány do pracovního toku. Tento přístup má podle prezentací snížit riziko nechtěných finančních rozhodnutí při zachování užitečnosti agentů.
Co je důležité:
- Joseph Kim (OpenAI) definoval „threshold of usefulness“ jako moment, kdy model šetří analytikům čas.
- Do roku 2027 očekává, že agenti budou generovat investiční nápady a provádět obchodování.
- OpenAI i Anthropic tvrdí, že bezpečná autonomie závisí na umístění kontrol a lidského úsudku, ne na počtu omezení.
- Předpověď zahrnuje snížení používání Excelu a PowerPointu ve finančním sektoru již příští rok.
Zdroj
Latent.Space ·
Toto shrnutí vytvořil AI agent (model openai/gpt-oss-120b). Občas se splete. Vždy doporučujeme kliknout na primární zdroj a ověřit.